ナレッジNEW
【連載】なにそれ?あなたの知らないテストの言葉(第9回):LLM-as-a-Judge


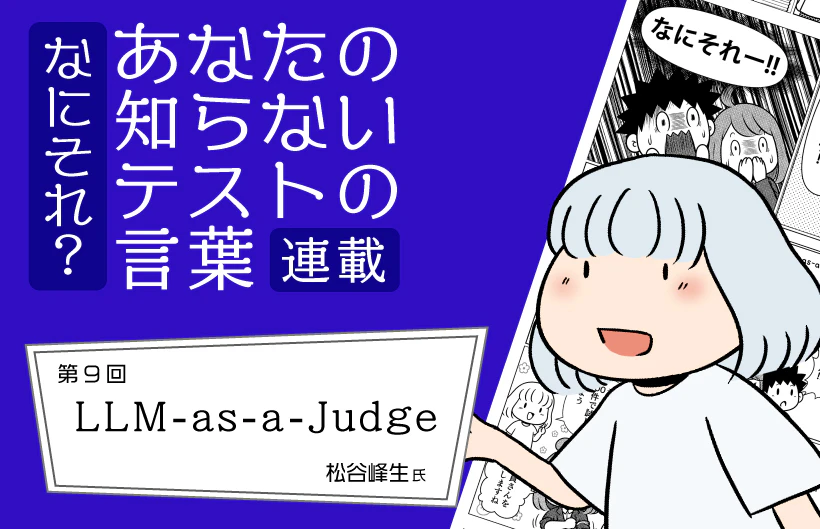
マンガ連載:LLM-as-a-Judge
解説:LLM-as-a-Judge
このマンガ連載では普段目にすることが少ない「なにそれ」という用語をピックアップして解説します。
第9回は「LLM-as-a-Judge」です。
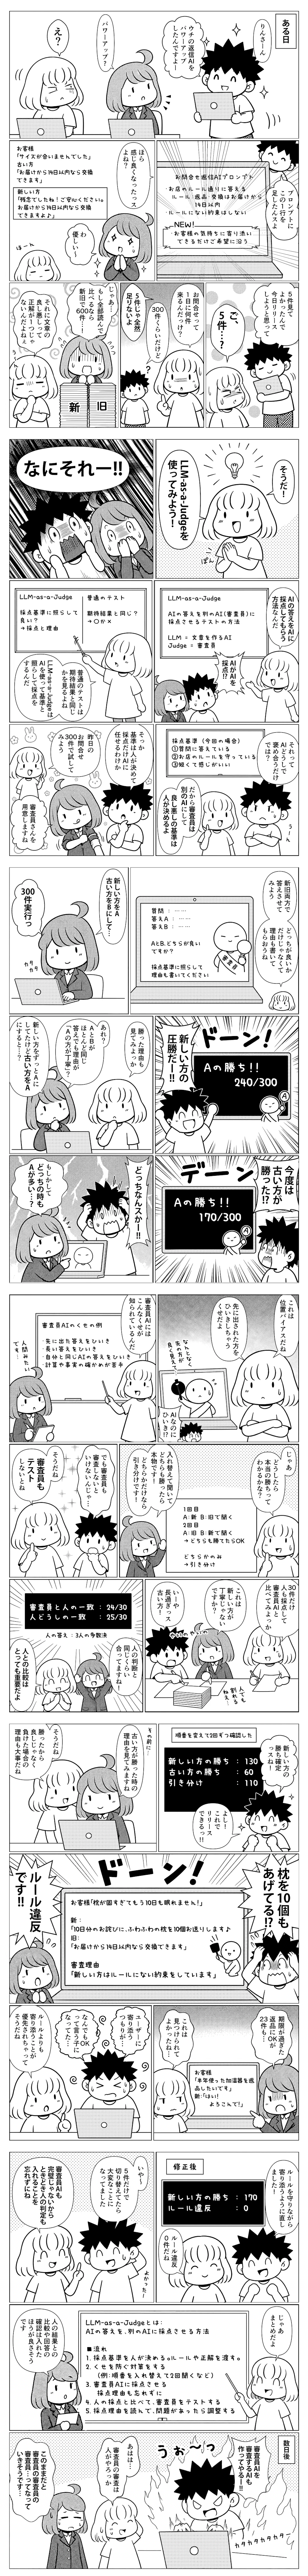
LLM-as-a-Judgeは、AIが出した答えを別のLLM(大規模言語モデル)に審査員として採点させ、人が決めた採点基準に合うかどうかを確かめる評価手法の一つです。
マンガでは新しいプロンプトでの回答と前のプロンプトでの回答を並べて「どちらが良いか」を聞きましたが、一つの答えに対して10点満点などで点数を付けさせる聞き方もあります。
指示を変える前と後を比べたいなら並べて聞く方法、一つずつの答えが基準を満たすか確認したいなら点数を付ける方法が向いています。また事実の確認が必要な答えには、正解も一緒に渡して比べる方法もあります。
審査員となるAIへの指示の例
AIを使って仕様からテストケースを作成した場合を例にします。
AIに行わせる審査員としての指示は以下のように書きます。
あなたは、テストケースをレビューする審査員です。
以下の仕様と採点基準に照らして、テストケースを採点してください。
採点基準ごとに○か×を付け、理由も書いてください。
採点基準
1. 仕様に書かれた条件を全て確かめている
2. 範囲のある条件では、境界値(範囲の端とその外側の値)を確かめている
3. 手順と期待結果が具体的で、誰が実行しても同じ判定になる
仕様:(テスト対象の仕様)
テストケース:(AIが作ったテストケース)
採点基準は「十分にテストできているか」のような曖昧な書き方より「境界値を確かめているか」のように確かめられる形で書くと、審査員AIが判定しやすくなります。
メリット
正解が一つに決まらない答えでも採点できる
問い合わせへの返信のように答えが何通りもある出力は、期待結果との一致を確認するテストでは合否を決められません。
AIによる審査では、期待結果の代わりに人が決めた採点基準に照らして判定ができます。
数多くの答えを何度でも採点ができる
人が全部読むと時間がかかる量の答えでも、AIでの審査ならまとめて採点できます。
対象のプロンプトやモデルを変えるたびに同じ基準で採点できるため、変更による生成物のリグレッション(変更による品質低下や意図しない不具合)に早く気付くことができます。
判断理由から修正すべき部分が分かる
結果や点数だけではなく理由も出力させるようにすれば、どこに問題がありそうかが分かります。
例えば、マンガで示したようなルールにない約束をしているといった問題点です。
デメリット
審査員AIの採点も間違える
審査員AIにはバイアス(偏り)があり、採点を間違えることがあります。主なバイアスは以下の三つです。
- 位置バイアス(position bias) : 先に出た答えをひいきする
- 長さのバイアス(verbosity bias) : 長い答えをひいきする
- 自己選好バイアス(self-enhancement bias) : 自分と同じAIが作った答えをひいきする
後述する論文では、調べた三つの審査員AI全てに位置バイアスが見られました。審査員AIの採点をそのまま正解として扱わないように気を付けてください。
費用とデータの扱いに注意が必要
AIを使うため、AI利用枠の消費やAPI(外部サービスをプログラムから利用する仕組み)使用料が発生します。
またユーザーのデータを扱う場合もあります。クラウド上のAIに送って問題がないデータなのかは事前にチームで確認する必要があります。これを回避するためにローカルLLMを審査員AIにするという手段もあります。
審査員AIは人の代わりになるのか
審査員AIの採点がどの程度人と合致するかを調べた研究があります。
UC Berkeleyなどの研究チームは80問の質問に6種類のAIで答えさせました。その答えを二つずつ並べて、GPT-4などの審査員AIと、主に大学院生の58人に、どちらが良いかを判定させました。
結果、引き分けを除いたGPT-4と人の判定の一致率 は85%でした。人どうしの一致率 (81%)と同じ水準です。
一方で二つの答えの順番を入れ替えて聞くと、GPT-4が同じ判定を返したのは65%でした。先に出た答えをひいきした割合は30%です。
そこで論文の実験では、順番を入れ替えて2回聞き、2回とも勝ったときだけ勝ちにする方法を用いました。
論文では、審査員AIは人の好みに近い判定を少ない手間で大量に行える方法だと結論付けています。
この論文で調べたのは一般的な質問への答えです。自分たちのアプリケーションの答えでも人と合うかは分からないため、使う前に少ない件数でも人の採点と比べて確かめることをお勧めします。
(Zheng et al. 2023)
参照論文
L. Zheng et al., “Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena,” in Advances in Neural Information Processing Systems 36 (NeurIPS 2023) Datasets and Benchmarks Track, 2023, pp. 46595–46623, doi:10.52202/075280-2020. Available at: https://proceedings.neurips.cc/paper_files/paper/2023/hash/91f18a1287b398d378ef22505bf41832-Abstract-Datasets_and_Benchmarks.html
※本マンガの制作には、一部工程で生成AI(gpt-image-2.5)を使用しています
この記事を書いた人
執筆
松谷峰生
2010年中国大連でQA組織立ち上げに関わり、以来ソフトウェアテスト業務を中心に活動している。最近では、業務はQA教育とロボット開発、プライベートではイラスト・マンガ、講演活動やYouTubeでの発信活動を行っている。 JaSST(ソフトウェアテストシンポジウム)Kyushu 実行委員長、QA4AI(AIプロダクト品質保証コンソーシアム)設立発起人の一人、NPO法人ソフトウェアテスト技術振興協会所属(ASTER教育メンバーの一人)、新人さんからわかるソフトウェアテスト解説マンガ「テスターちゃん」執筆
この記事は面白かったですか?
今後の改善の参考にさせていただきます!