ナレッジ
AIのモデル学習とは何をすること?仕組みとプロセス、過学習の防ぎ方を解説


AI導入を進めるときに、「モデルを学習させる」「学習済みモデルを使う」「推論させる」といった検討事項が上がります。
しかし、モデル、アルゴリズム、学習、推論は似た場面で使われるため、役割の違いが分かりにくいものです。
この記事では、基本的なAIモデル学習の仕組みから、心理学用語との違いといった用語の違い、モデル学習を業務に適用する上でのポイントなどを実務目線で整理・解説します。
AIのモデル学習とは?
モデル学習とは、入力データから目的に合う規則性を見つけ、誤差が小さくなるようモデルのパラメータを調整する工程です。
まずはモデルの定義、学習の仕組み、混同されやすい用語との違いを順に押さえていきましょう。
AI・機械学習における「モデル」の定義
AIは、人間が知的だと感じる判断や生成をコンピューターで実現する技術の総称です。機械学習はAIの一分野で、データからモデルを訓練し、未知のデータを予測・分類する仕組みを指します。
AIモデルは幅広い意味で使われますが、ここでは主に機械学習によって得られるモデルを扱います。モデルとは、入力から出力を導く数学的な関数、またはその構造とパラメータの組み合わせです。
ニューラルネットワークの重みやバイアス、決定木の分岐条件など、学習によって決まる値がモデルの振る舞いを形づくります。モデルは単なるデータやプログラムではなく、データから得た規則性を基に予測するための成果物です。
通常のプログラムでは、人が処理手順を一つずつ決めます。
一方、機械学習では、人が学習方法や評価方法を設計し、具体的なパラメータはデータから決まります。
ただし、学習によって業務の目的まで自動的に決まるわけではありません。何を正解とし、どの誤りを許容しないかは、人があらかじめ定義する必要があります。
モデルを学習させる仕組みとプロセス
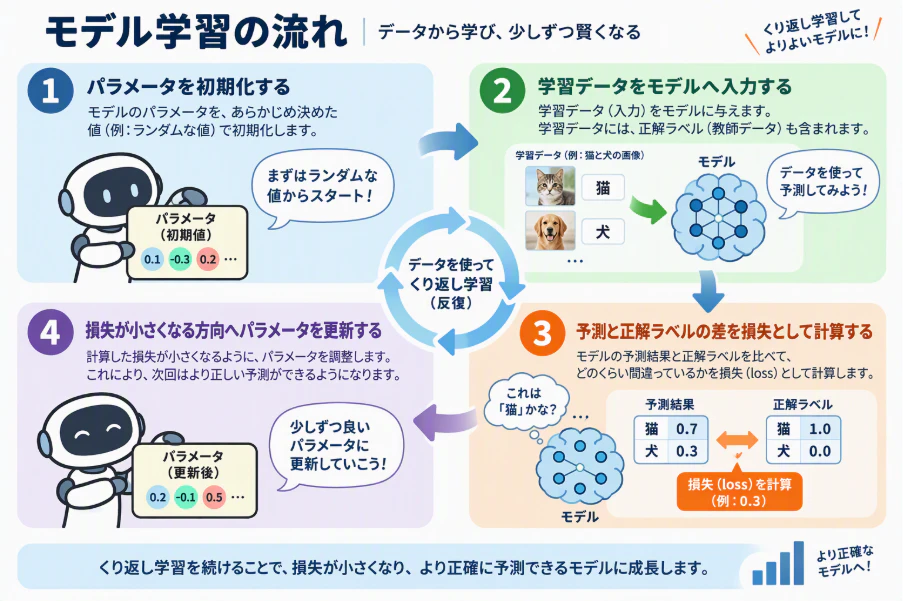
モデル学習は、主に次の流れで進みます(図表1)。
- パラメータを初期化する
- 学習データをモデルへ入力する
- モデルの予測と正解ラベルの差を損失(loss)として計算する
- 損失が小さくなる方向へパラメータを更新する
ニューラルネットワークでは、入力データから予測と損失を計算する順方向の処理と、誤差を各層へ伝えて重みを更新する逆方向の処理を繰り返します。Google for Developersの用語集でも、順方向で損失を求め、逆方向で重みを調整する流れが説明されています。
ただし、パラメータを一度更新しただけでは、十分な規則性は得られません。そのため、データを「バッチ」と呼ばれる小さなまとまりに分け、更新を何度も繰り返します。訓練データ全体を一巡する単位が「エポック」です。
一方、学習は続けるほど良くなるわけでもありません。訓練データへの適合が進み過ぎると、未知のデータに対する性能がかえって低下することがあります。この状態を「過学習」と呼びます。
過学習を防ぐには、学習の途中で検証データを使って性能を確認しなければなりません。訓練データに対する精度だけで判断せず、検証性能が最も高かった時点のモデルを採用することが重要です。
学習では、データと学習規則を使ってモデルのパラメータを繰り返し更新します。これに対し、推論では、学習後に固定したパラメータをモデルへ新しいデータを入力し、予測結果を得ます。
学習によって得たモデルを運用環境へ渡す段階が、学習と推論を分ける境界です。
心理学用語・英語表現との違い
「モデル学習」は、AI以外の文脈でも使われます。
心理学における「観察学習」や「モデリング」は、他者の行動を観察・模倣して身に付けることです。
ここでのモデルは行動を示す人や対象を指すため、AIのモデル学習とは意味が異なります。APA Dictionary of Psychologyでも、modelingとobservational learningは心理学用語として整理されています。
「学習モデル」は、モデル学習によって得られたものを指す場合がありますが、意味が一義的に定まった標準用語ではありません。
公開資料や要件書では、「学習前のモデル構造」「学習済みモデル」「推論サービス」のように、状態を具体的に書き分けると誤解を防げます。
モデル・アルゴリズム・推論の違い
モデル、アルゴリズム、推論という三つの言葉は、AIの説明でよく混同されます。
それぞれが指す範囲を分けて理解すると、学習と運用の工程で何を管理すべきかが見えてきます。
モデルとアルゴリズムの違い
アルゴリズムとは、問題を解くための手順や計算方法そのものです。線形回帰、決定木、ランダムフォレスト、勾配ブースティングなどが該当します。
一方、モデルは、アルゴリズムを実際のデータで学習させ、具体的なパラメータを持たせたものです。同じアルゴリズムでも、学習データ、乱数、ハイパーパラメータが異なれば、モデルの中身や予測結果も変わります(図表2)。
アルゴリズムが「作り方のレシピ」なら、モデルは「そのレシピで実際に焼いたパン」と考えると分かりやすいでしょう。
用語 | 役割 | 実務で主に確認すること |
|---|---|---|
モデル | 学習で得たパラメータを使い、入力から出力を計算する | 入出力、サイズ、バージョン、適用範囲 |
アルゴリズム | モデルを構成・学習するための計算方法 | データとの相性、精度、説明性、計算量 |
学習(training) | データを使ってモデルのパラメータを調整する | 訓練データ、評価方法、学習率、再現性 |
推論(inference) | 学習済みモデルから予測や生成結果を得る | 処理速度、前処理、監視、失敗時の対応 |
図表2:用語ごとの役割の違い
これらを混同すると、「モデルの精度が落ちた」と考えていた問題が、実際には前処理や運用環境の変化によって起きていたということもあります。役割を分けて理解しておくと、問題が発生した箇所を特定しやすくなります。
出典:Machine Learning Glossary|Google for Developers
学習と推論の違い
学習は、正解や目的に合わせてモデルのパラメータを調整する工程です。
推論は、学習済みモデルのパラメータを基本的に固定し、新しい入力から結果を求める工程を指します(図表3)。
項目 | 学習 | 推論 |
|---|---|---|
目的 | モデルの性能を高める | 予測や判定結果を得る |
使用するデータ | 学習データと正解ラベル | 新しい入力データ |
モデルの状態 | パラメータを更新する | 原則として更新しない |
図表3:学習と推論の違い
不良品を判定する画像認識モデルの場合、学習時には過去の画像と正解ラベルを使って重みを更新します。運用時には、新しく撮影した画像を入力し、判定結果とその確信度を出力します。
このとき重要なのが、前処理の一致です。学習時に画像の明るさやサイズを標準化した場合、推論時にも同じ方法で変換する必要があります。前処理が異なると、モデルの性能が大きく低下する可能性があります。
推論方式は、主にバッチ推論とオンライン推論の二つがあります。
バッチ推論は、大量のデータをまとめて処理し定期的な需要予測、全データのスコアリングなどに用いられます。
オンライン推論はリクエストごとに結果を返し、画面への即時応答、検査ラインでの判定などに用いられます。
オンライン推論では、応答時間と計算資源の確保が重要です。モデルを選ぶ際は、精度だけでなく、レイテンシーや同時に処理できるリクエスト数も確認しましょう。
モデルの過学習の原因と防ぐための対策
過学習とは、モデルが訓練データの特徴やノイズを覚え込み、未知のデータに対する性能が低下する状態です。訓練損失が下がり続ける一方で、検証損失が上がり始めた場合は、過学習が疑われます。
主な原因と対策は次のとおりです(図表4)。
原因 | 主な対策 |
|---|---|
データ量に対してモデルが複雑すぎる | モデルを単純化する、L1・L2正則化やドロップアウトを使う |
訓練データが偏っている | 実際の運用条件を含むデータを追加する |
ラベルの誤りやデータの重複がある | ラベルを見直し、重複データを除く |
エポック数が多過ぎる | 検証損失が悪化する前に学習を止める |
データ量が不足している | データを追加し、画像では反転や切り出しなどのデータ拡張も行う |
データリーケージが起きている | データ自体や分割方法、前処理の方法を見直す |
図表4:過学習の主な原因と対策
対策の効果を比較するには、使用したデータ、正解ラベルの基準、設定値、採用したモデルを記録する必要があります。
交差検証を使える場合は、分割による評価のばらつきも確認しましょう。
ただし、時系列データや同じ対象を撮影した複数の画像をランダムに分けると、性能が実際より高く見える可能性があります。時間や設備、顧客、撮影対象など、業務上の単位に合わせてデータを選定することが重要です。
業務へのAIモデル導入に向けて
AIモデルは、精度だけで選ぶものではありません。業務上のKPIや誤判定の影響を明確にし、総合的に比較できる項目例を以下に挙げます。
- 精度と説明のしやすさ
- 応答時間と運用コスト
- データの取り扱い
- 監視・更新のしやすさ
- 誤判定時の対応方法
費用には、学習環境だけでなく、データ収集、アノテーション、推論サーバー、監視、再学習にかかる負担も含まれます。要件を満たせるなら、小規模なモデルの方が導入・運用しやすい場合もあります。
導入後は、データの変化や精度低下を監視し、必要に応じて再学習します。個人情報、セキュリティ、公平性、安全性も確認し、重要な判断では人による確認や代替手段を用意しましょう。
モデル選定の目的は、最も高い精度を出すことではありません。自社の業務、予算、リスクに合い、継続して改善できるAIシステムを構築することが重要です。
■参考文献・資料■
- Machine Learning Glossary|Google for Developers
- Common pitfalls and recommended practices|scikit-learn
- Datasets: Dividing the original dataset|Google for Developers
- modeling|APA Dictionary of Psychology
- observational learning|APA Dictionary of Psychology
- Transfer learning and fine-tuning|TensorFlow Core
- BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding|Jacob Devlinほか
この記事を書いた人
執筆
HQW!編集部
ソフトウェア品質保証・テスト分野の知見を持つ株式会社ベリサーブが運営するオウンドメディア「Hello, Quality World!」の編集チーム。技術書の執筆・監修経験者を含むベリサーブ広報部と、ITメディア編集経験者を含む外部編集スタッフで構成される。ベリサーブの技術者や各分野の専門家への取材・監修を基に、品質保証、ソフトウェアテスト、DX、AI、開発手法、IT人材育成など、IT業界に役立つ情報を企画・編集・発信。読者に正確で信頼できる情報を届けるため、公開前には内容の事実確認や専門部門による確認を実施し、分かりやすく実務に生かせるコンテンツづくりを心掛ける。 株式会社ベリサーブは、ソフトウェア品質保証サービスを提供する企業として、40年以上にわたり1,200社以上の企業の品質向上を支援している。
この記事は面白かったですか?
今後の改善の参考にさせていただきます!